Im vorigen Beitrag haben wir beleuchtet, warum Standard-Runtimes wie LM Studio und Ollama bei asynchronen Agenten-Schwärmen an ihre Grenzen stoßen und wie H.U.G.I.N.N. über den Thalamus EventBus die Inferenz-Anfragen entkoppelt.
Doch die eleganteste Entkopplung auf Software-Ebene nützt wenig, wenn die physische Hardware kapituliert: Wie betreibt man spezialisierte Vision-, Kognitions- und Coding-Modelle auf einer lokalen Workstation mit regulären 16 GB Grafikspeicher, ohne dass das System in einen Out-of-Memory-Absturz (OOM) läuft?
Die Antwort ist das Herzstück unseres Backends: die VGPU (Virtual GPU) und ihre dreistufige Tiered-Memory-Architektur.
Das Dilemma: Fragmentierung vs. I/O-Kollaps
In einem Multi-Agenten-System treten zwei gegensätzliche Speicheranforderungen auf: 1. Gleichzeitiges Vorhalten: Hält man mehrere quantisierte Modelle parallel im VRAM, fragmentiert der Adressraum. Für den dynamisch anwachsenden KV-Cache langer Kontexte bleibt kein Puffer – der Treiber quittiert den Dienst mit einem OOM-Crash. 2. Naiver Modellwechsel: Lädt man Modelle bei jedem Aufgabenwechsel komplett neu von der Festplatte, bricht die Inferenzrate ein. Selbst schnelle NVMe-Laufwerke erzeugen beim vollständigen Initialisieren von 8 bis 14 GB großen GGUF-Tensoren spürbare Latenzen.
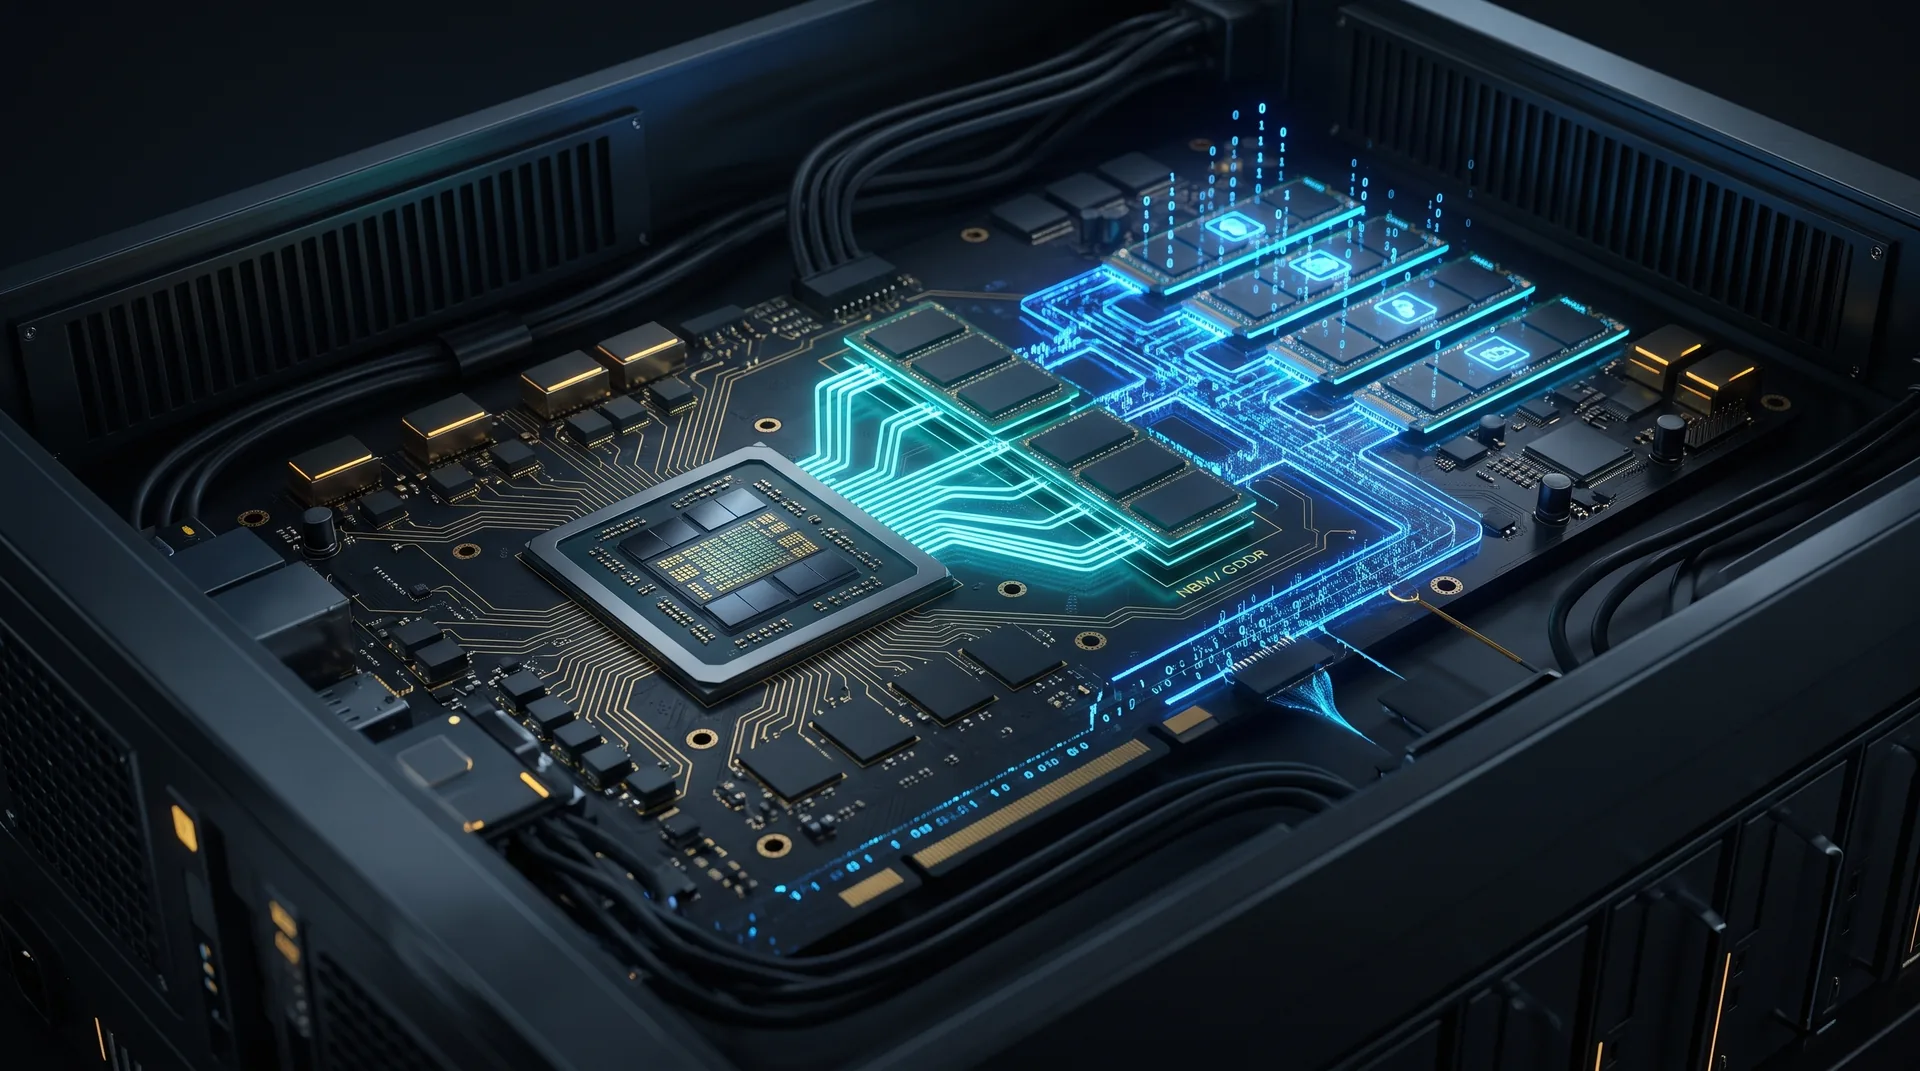
Um diesen Zielkonflikt zu lösen, behandelt H.U.G.I.N.N. die Grafikkarte nicht mehr als isolierten Einzelspeicher, sondern spannt einen virtuellen Speicherpool über drei hierarchische Schichten auf.
Die 3-stufige Tiered-Memory-Hierarchie
Statt Alles-oder-Nichts verwaltet die VGPU die Tensorblöcke und State-Caches dynamisch über Bus- und Speicherbarrieren hinweg:
 ┌────────────────────────────────────────────────────────┐
 │ TIER 0: GPU VRAM (16 GB) - Hot Execution Layer │
 │ • Aktiver Inferenz-Kern & dynamischer KV-Cache │
 │ • Höchste Bandbreite (z. B. GDDR6 / GDDR6X) │
 └─────────────────────────┬──────────────────────────────┘
 ▼ (Zero-Copy Transfer / Host-Offload)
 ┌────────────────────────────────────────────────────────┐
 │ TIER 1: System-RAM (Host DDR) - Warm Standby │
 │ • Resident geparkte Layer inaktiver Modellinstanzen │
 │ • Schneller Layer-Swap ohne Festplatten-I/O │
 └─────────────────────────┬──────────────────────────────┘
 ▼ (Kernel-Level Zero-Latency Paging)
 ┌────────────────────────────────────────────────────────┐
 │ TIER 2: NVMe SSD - Cold Model Vault via OS-mmap │
 │ • GGUF-Tensoren direkt im virtuellen Adressraum │
 │ • Blockweises Nachladen via Kernel Page-Faults │
 └────────────────────────────────────────────────────────┘
1. Tier 0: Physisches VRAM (Hot Layer)
Der Grafikspeicher gehört während der Token-Generierung exklusiv dem ausführenden Graph. Hier liegen nur die unmittelbar berechneten Gewichte sowie der wachsende KV-Cache. Das garantiert maximale Speicherbandbreite ohne thermische oder busseitige Drosselung.
2. Tier 1: Host System-RAM (Warm Standby)
Wird ein Modell temporär nicht für die Generierung gebraucht, wird es nicht verworfen. Die VGPU transferiert inaktive Layer über den PCIe-Bus in den System-Arbeitsspeicher (z. B. 64 GB DDR5). Durch vorbereitete Direct-Memory-Mappings stehen diese Schichten bei der nächsten Anfrage in Millisekundenbruchteilen wieder bereit – ganz ohne Kaltstart von der SSD.
3. Tier 2: NVMe Memory-Mapping (mmap)
Alle quantisierten Modelle liegen in unserem internen Vault. Anstatt Modelldateien sequentiell in den RAM einzulesen, bindet H.U.G.I.N.N. die GGUF-Tensoren via Kernel-Level mmap ein. Das Betriebssystem mappt die Datei direkt in den virtuellen Adressraum. Das System liest nur exakt jene Pages von der NVMe, die für den Rechenlauf referenziert werden – ungenutzte Gewichte belasten zu keinem Zeitpunkt den physischen Arbeitsspeicher.
Der physikalische Preis: Der PCIe-Flaschenhals
Jede Speicher-Virtualisierung unterliegt den Gesetzen der Physik. Wer behauptet, ein Modell beliebig zwischen GPU, RAM und NVMe verschieben zu können, ohne Geschwindigkeit einzubüßen, verschweigt die Bandbreiten-Realität:
- GPU VRAM (GDDR6/GDDR6X): Liefert 500 bis 1.000 GB/s Bandbreite. Die Rechenkerne werden mit voller Geschwindigkeit mit Tensordaten versorgt.
- PCIe 4.0 / 5.0 x16: Begrenzt den Durchsatz auf netto rund 31,5 bis 63 GB/s.
- System-DDR-RAM: Bringt im Dual-Channel-Betrieb typischerweise 50 bis 80 GB/s.
Sobald ein Modell größer ist als die physisch verfügbaren 16 GB VRAM (z. B. bei stark quantisierten 27B- oder 70B-Modellen) und Layer über den PCIe-Bus aus dem System-RAM abgearbeitet werden müssen, verschiebt sich der Engpass: Nicht mehr die Tensor-Cores limitieren die Geschwindigkeit, sondern der Bus-Durchsatz.
In der Praxis sinkt die Generierungsgeschwindigkeit bei starkem CPU/RAM-Offloading von ehemals 35–50 Tokens/s auf 3 bis 8 Tokens/s ab.
Warum der Trade-off in L.U.N.A. trotzdem aufgeht
In einem interaktiven Chat-Programm wäre ein solcher Einbruch frustrierend. In einer asynchronen Multi-Agenten-Architektur wie L.U.N.A. ist er jedoch ein entscheidender strategischer Vorteil:
- Verfügbarkeit schlägt Totalabsturz: Wenn Agent Prof. Simon eine tiefe semantische Analyse oder ein Code-Audit durchführen muss, ist ein stabiler Durchlauf mit 5 Tokens/s unendlich wertvoller als ein Systemabbruch durch Out-of-Memory.
- Entkopplung via Thalamus: Da Agenten Inferenz über Tickets an den EventBus übergeben, blockiert ein großes, ausgelagertes Modell nicht den Rest des Organismus. Leichtgewichtige Agenten (z. B. auf 4B- oder 9B-Basis) feuern komplett im schnellen VRAM, während schwere Hintergrund-Audits asynchron im Tier 1 abgearbeitet werden.
- Autonome Rückkehr zur Maximalleistung: Sobald die schwere Aufgabe erledigt ist, gibt der VRAM-Lease-Manager die Ressourcen deterministisch frei. Nachfolgende Prozesse erhalten sofort wieder die volle GDDR-Bandbreite.
Fazit: Determinismus auf Standard-Hardware
H.U.G.I.N.N. beweist, dass fortschrittliche Multi-Agenten-Forschung nicht an Server-Clustern mit sechsstelligen Budgets hängen muss. Wer die physikalischen Grenzen des PCIe-Busses akzeptiert und das Speichertiering über VRAM, Host-DDR und NVMe-mmap beherrscht, verwandelt eine reguläre 16-GB-Workstation in eine verlässliche kognitive Schaltzentrale.