Jenseits von JEV: Wie L.U.N.A. Prime ein vollautonomes, deterministisches Weltmodell aufbaut
Von stochastischen Sprachmodellen zu fehlerfreier, maschineller Gewissheit
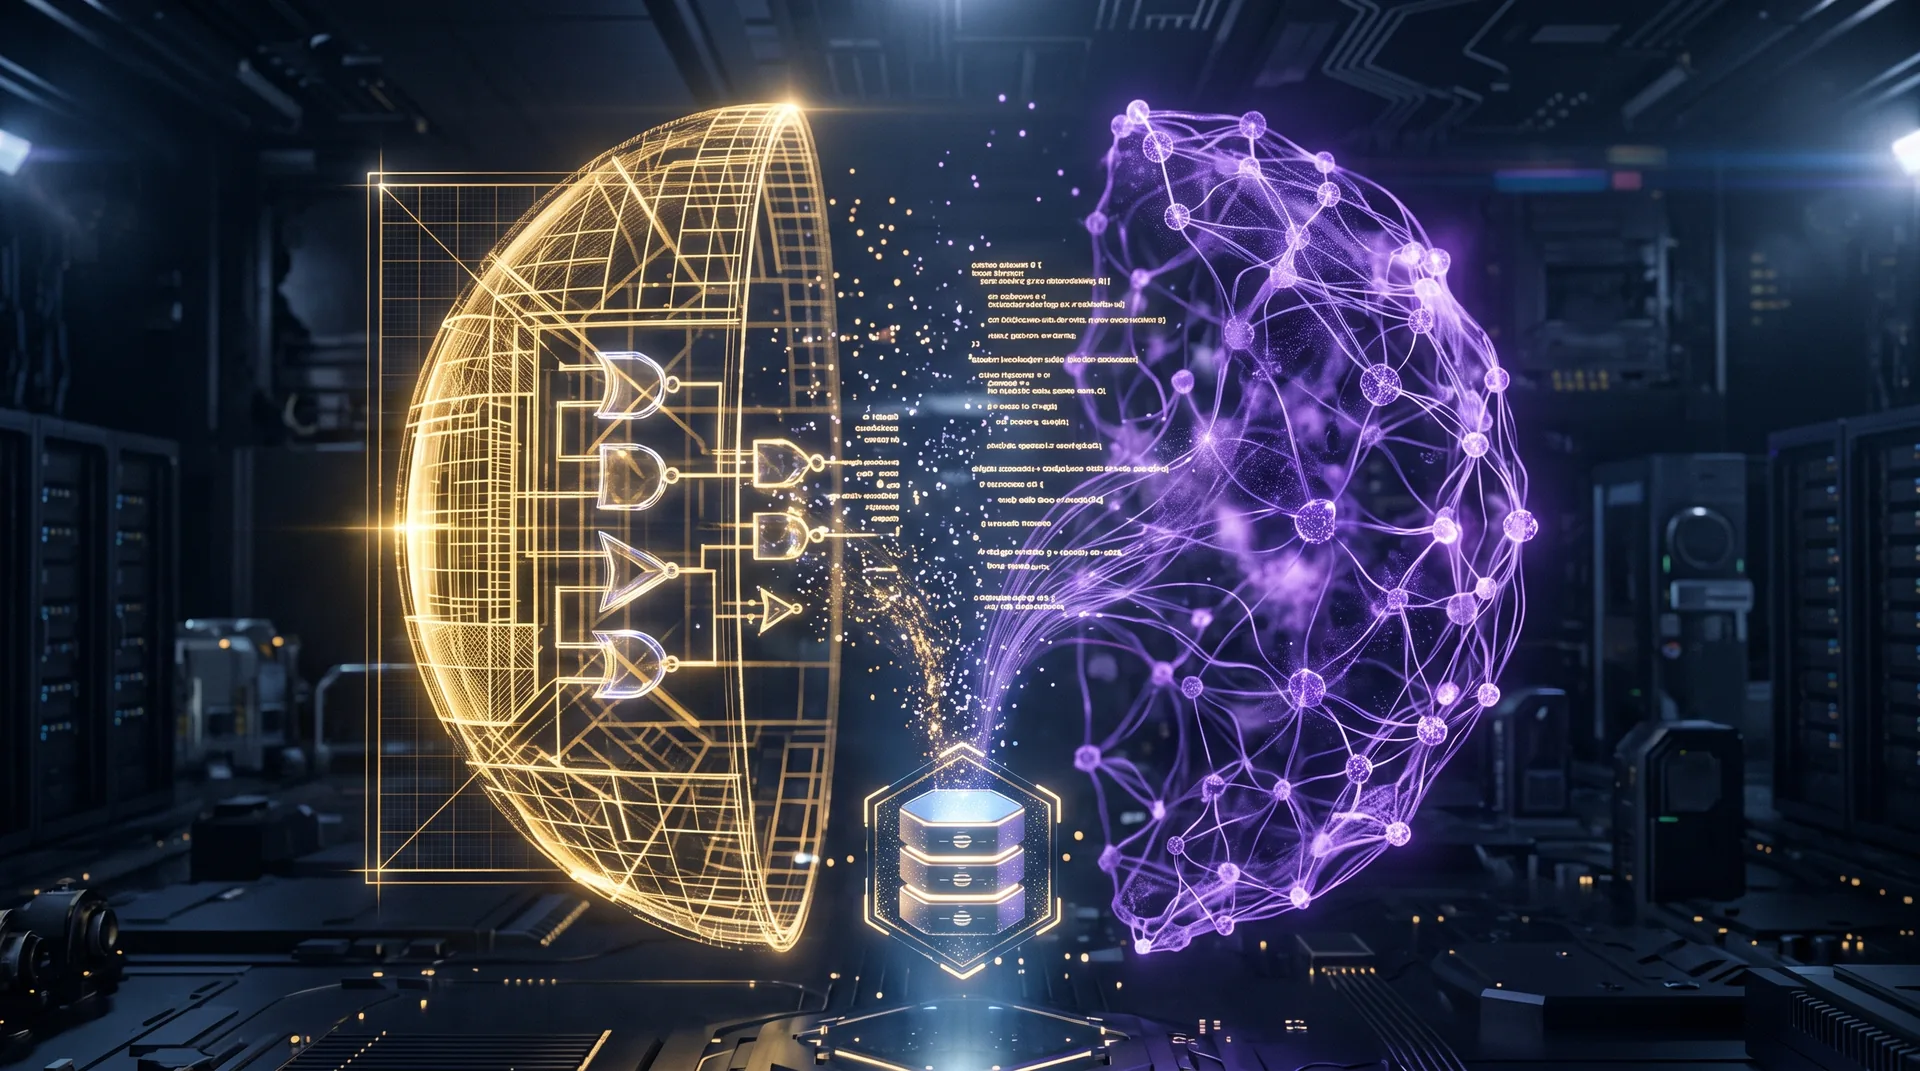
In der aktuellen KI-Forschung gilt das sogenannte JEV-Modell (Joint Embedding / Verifiable Ingestion) als wichtiger Meilenstein: Wissen wird aus Vektoren und textuellen Korpora extrahiert und in semantische Repräsentationen eingebettet. Doch in der Praxis leiden rein generative Architekturen unter einer chronischen Krankheit: stochastischem Halbwissen. LLMs klingen überzeugend, fabrizieren aber subtile Syntaxbrüche, verwechseln DOM-Hierarchien und halluzinieren logische Widersprüche herbei, wenn keine deterministische Kontrollinstanz eingreift.
Mit L.U.N.A. Prime sind wir einen radikalen Schritt weitergegangen. Unser System trennt akademische Spezialisierung vom allgemeinen Weltmodell und automatisiert den gesamten Lernprozess über einen geschlossenen, deterministischen Trainings- und Prüfzyklus.
1. Das Zwei-Säulen-Prinzip: Allgemeines Weltmodell vs. Akademie
Traditionelle KI-Trainingsansätze werfen alles in einen einzigen Kontext. Scheitert das System an den Grundlagen, versagt auch die Spezialisierung. L.U.N.A. Prime trennt diese Ebenen strikt:
- Das fundamentale Weltmodell (
luna_wiki.db): Hier liegen unumstößliche, mathematisch und syntaktisch verifizierte Axiome. L.U.N.A. lernt die Grundlagen der Welt (HTML-DOM-Hierarchien, W3C-Standards, CSS-Box-Modelle, C-Pointer-Arithmetik, formale Logik) als unverrückbare Wahrheiten. Abfragen an dieses Modell erfolgen mit 0% Inferenzaufwand – absolut latenzfrei, deterministisch und reproduzierbar. - Die Akademie (
luna_academy.db): Sie fungiert nicht als Grundlagenkurs, sondern als Spezialisierungs-Universität. Hier vertieft L.U.N.A. komplexe Domänen wie Post-Quantum-Kryptographie, Signal-Entfaltung der MoonEngine oder asymmetrische Simulationsstrategien.
2. Der Konsens-Zirkel: Dual-LLM Ingestion & Paraphrasen-Toleranz
Der größte Fehler beim Training mit Sprachmodellen besteht darin, eine KI sich selbst korrigieren zu lassen. L.U.N.A. Prime löst dies über ein adversariales Kontrollverfahren:
- Unabhängige Konsens-Inferenz: Jede neue Wissenseinheit wird parallel von zwei entkoppelten Modell-Instanzen generiert.
- Semantischer Jaccard- & Schnittmengen-Test: Weichen die Erklärungen inhaltlich voneinander ab, greift das System sofort ein.
- AST-Normalisierung: Code wird nicht als Text verglichen. Ein abstrakter Syntaxbaum (AST) extrahiert den rein funktionalen Kern. Ob L.U.N.A. Leerzeichen setzt oder Variablennamen paraphrasiert, spielt keine Rolle – nur die mathematische und strukturelle Identität zählt.
- Symmetrische Negativ-Erfahrung: Zu jedem akzeptierten Axiom wird das exakte, abgewiesene Gegenstück als
Negative Sampleinerror_experienceregistriert. L.U.N.A. lernt nicht nur, was wahr ist, sondern begreift präzise, welcher Fehler warum abgewiesen wurde.
3. Die unbestechliche Abschlussprüfung: 100% Airgap-Verifikation
Das entscheidende Differenzierungsmerkmal zum JEV-Modell ist der Gatekeeper am Ende jedes Lernzyklus:
Während des Trainings liegen die Referenzlösungen in einem isolierten Quarantäne-Speicher (exam_vault), auf den L.U.N.A. keinen Zugriff hat. Schummeln ist ausgeschlossen.
Sobald der Lernabschnitt durchlaufen ist, schaltet der Kernel die Inferenz vollständig ab (Hard-Airgap). L.U.N.A. muss die zuvor erfassten Wissenslücken nun rein offline aus ihrer relationalen Datenbank rekonstruieren.
Der Zyklus gilt erst dann als bestanden, wenn die Erfolgsquote bei exakt 100% liegt.
Besteht auch nur ein einziges Axiom die Syntax- oder Logikprüfung nicht, wird kein ECTS vergeben, kein Status auf RESOLVED gesetzt und der nächste Vertiefungslauf initiiert.
Fazit: Autonomie durch Verifikation
Durch diesen hybriden Aufbau aus relationaler Datenbank, AST-Parsing und Dual-LLM-Schlichtung heben wir L.U.N.A. Prime auf ein neues Niveau. Sie ist kein stochastischer Papagei mehr, der rät, was als Nächstes kommen könnte, sondern ein autonomer Kognitionskern, der sein eigenes Weltmodell strukturiert aufbaut, prüft und unumstößlich absichert.