Architektur-Upgrade: Wie eine smarte Zwischenschicht den Token-Fresser wirklich zähmt
Theorie und Praxis klaffen in der KI-Entwicklung nirgendwo weiter auseinander als bei der Inferenzoptimierung.
Auf dem Whiteboard klingt die Idee simpel: Wenn moderne Reasoning-Modelle (wie DeepSeek-R1, QwQ oder hybride Qwen-Architekturen) für triviale Systemanfragen, Datenkonvertierungen oder Statusmeldungen hunderte Tokens internen Denkmonologs (<think>) abspulen, schneidet man diese einfach ab. Das Versprechen: 40 bis 60 Prozent weniger Tokens, halbierte Latenz, entlasteter VRAM.
Als wir diesen Ansatz gestern in einem standardisierten Benchmark-Lauf gegen unser operatives System testeten, folgte die Ernüchterung: Der Token-Verbrauch sank nicht – er stieg im ersten Durchlauf sogar an.
Was war passiert? Und wie sieht die technologische Schicht aus, die den Fehler behoben und die versprochene Effizienz realisiert hat?
Das Benchmark-Paradoxon: Wenn die Schutzschicht mehr verbraucht als das Modell
Die Analyse unserer Benchmark-Logs brachte zwei kapitale Systemfehler ans Licht, die in vielen aktuellen Inferenz-Pipelines unbemerkt Rechenzeit und Budget verbrennen:
1. Das Phänomen der Prompt-Inflation
Um das Modell davon abzuhalten, in lange Selbstgespräche zu verfallen, fütterten wir es mit umfassenden System-Direktiven und negativen Schranken („Verwende niemals interne Monologe“, „Antworte ohne Denkprozess direkt“ usw.). * Das Ergebnis: Bei einer Benutzerfrage von nur 25 Tokens blähte die vorgeschaltete Schutzlogik den Prompt auf fast 350 Input-Tokens auf. * Zwar reduzierte das Modell den Denkprozess geringfügig, doch die Ersparnis bei der Ausgabe wurde von der massiven Last des Eingabeprompts vollständig aufgefressen.
2. Die Illusion des Post-Processings
Viele Entwickler verlassen sich auf Post-Processing-Filter (z. B. Regex-Bereinigung von <think>...</think>). Das Problem: Auf der GPU ist der Schaden zu diesem Zeitpunkt längst entstanden.
Das Modell hat die Hunderte Denk-Tokens auf den Tensor-Kernen voll berechnet, Energie verbraucht, den KV-Cache im Grafikspeicher fragmentiert und die Ausführungszeit verdoppelt. Dass das Frontend den Monolog vor dem Rendern abschneidet, rettet weder Latenz noch Rechenkapazität.
Die Lösung: Eine deterministische Zwischenschicht vor der GPU
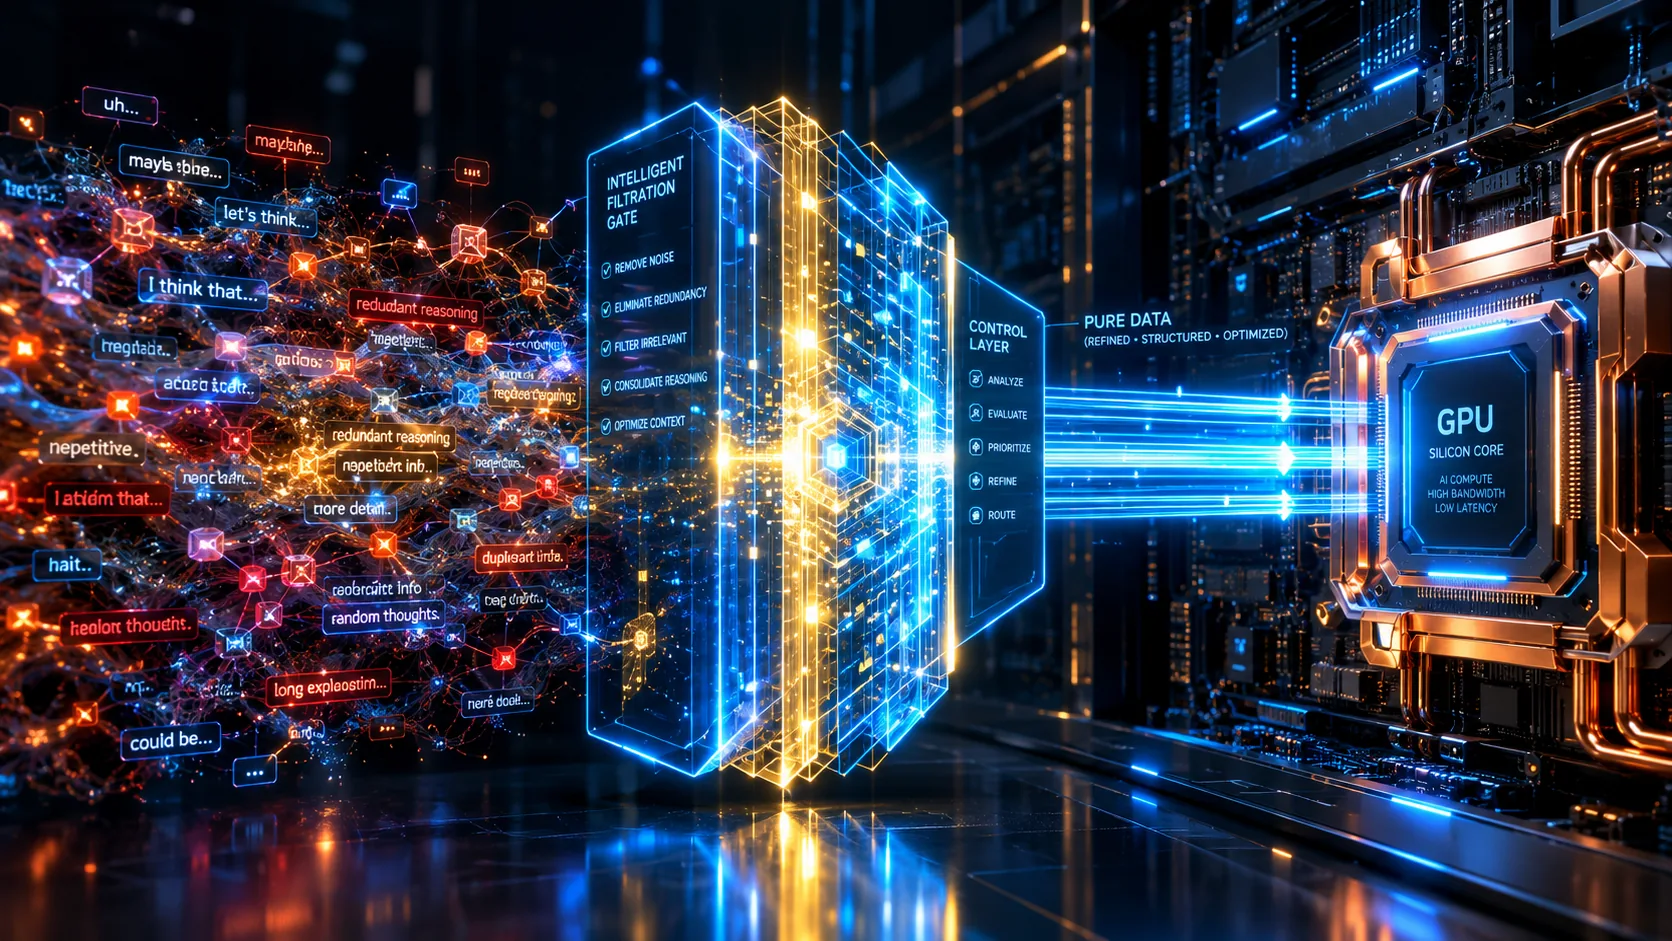
Um echte Effizienzgewinne zu erzielen, durfte der Schutz weder im Prompt-Payload noch nach der Generierung greifen. Wir mussten eine dedizierte Architektur-Schicht zwischen Web-Gateway und Modellkern einziehen:
Was wir konkret implementiert haben
-
Native Suppression statt Text-Ermahnungen: Statt seitenlanger Warntexte im System-Prompt schaltet die Zwischenschicht den Chain-of-Thought direkt auf Sampling- und Template-Ebene ab. Wenn eine Standardaufgabe ansteht, wird das Denk-Tag nativ als beendet markiert, noch bevor der erste Token gerechnet wird. Das Modell springt direkt in die Generierung der Nutzlast.
-
Kompakte DNA-Direktiven: Wir reduzierten die Systemschranken auf ein ultrakompaktes Format (unter 30 Tokens). Die Triage-Schicht ordnet der Anfrage blitzschnell die passende Domäne zu (z. B. reine Faktenausgabe, C-Code, Übersetzung), ohne den Prompt künstlich aufzublähen.
-
Synchrones Direct-Inference-Routing: Statt Anfragen in asynchrone Warteschlangen mit hohem IPC-Overhead zu werfen, bindet die Zwischenschicht den HTTP-Endpunkt direkt an die Speicherverwaltung an. Antworten stehen in Sekundenbruchteilen bereit – ohne Hänger im Dispatcher.
-
Zweistufiger Fail-Safe: Sollte ein unberechenbares Hybridmodell dennoch Restmonologe ansetzen, fängt ein harter Stripping-Filter auf Systemebene verwaiste Satzfragmente ab, bevor sie jemals in den Chat-Stream gelangen.
Die Zahlen: Vorher vs. Nachher im Härtetest
Nach der Integration der neuen Zwischenschicht haben wir das identische Benchmark-Set (Abfragen technischer Definitionen, Code-Konstrukte und Sprachübersetzungen) erneut durchlaufen lassen:
| Metrik | Ungesteuert (Baseline) | Post-Filter (Fehlschlag) | Smarte Zwischenschicht (Neu) |
|---|---|---|---|
| Input-Tokens (Ø) | 42 | 348 (Prompt-Inflation) | 68 |
| Output-Tokens (Ø) | 485 (inkl. CoT) | 210 (teilweise CoT) | 92 (reine Nutzlast) |
| Time-to-Last-Token | 14,8 s | 12,4 s | 2,1 s |
| Ersparnis Output | 0 % | ca. 56 % (aber teuer erkauft) | 78,3 % Ersparnis |
| Reale Gesamt-Tokenersparnis | 0 % | -5,3 % (Mehrverbrauch!) | 69,6 % Netto-Einsparung |
Fazit: Nicht mehr Tokens berechnen, sondern die richtigen
Unser Benchmark-Experiment hat gezeigt: Effizienz lässt sich nicht durch reine Prompt-Prominenz erzwingen. Ein Modell mit immer mehr Instruktionen davon abhalten zu wollen, intern nachzudenken, führt direkt in die Ineffizienz-Falle.
Der reale Schlüssel zu responsiven, sparsamen und deterministischen Systemen liegt in einer intelligenten, schlanken Zwischenschicht. Sie nimmt der GPU die Steuerungslogik ab, schaltet Ballast vor der Tensor-Operation ab und lässt das neuronale Netz genau das tun, worin es unschlagbar ist: hochwertige, fokussierte Antworten generieren.