Das Effizienz-Dilemma der KI: Warum smarte Pipelines den Denk-Overhead stoppen müssen
Die Debatte um künstliche Intelligenz dreht sich fast ausschließlich um Modellgrößen, Quantisierungsstufen und Benchmark-Tabellen. Ob auf der lokalen Workstation oder in großen Rechenzentren: Meist wird primär nach mehr Parametern bei möglichst geringer Latenz gestrebt.
Dabei bleibt der größte operative Flaschenhals moderner Sprachmodelle oft im Schatten: der unkontrollierte Inferenz-Overhead.
Seit moderne Architekturen zunehmend auf ausgeprägte Denkprozesse (Chain-of-Thought, häufig in internen <think>-Blöcken) trainiert werden, verbringen sie erhebliche Rechenzeit mit internen Selbstgesprächen. Was bei hochkomplexen Logikrätseln oder mathematischen Beweisen einen Mehrwert bietet, erweist sich in automatisierten Prozessen – etwa bei Content-Management-Systemen, Dokumentations-Generatoren oder Schnittstellen-Pipelines – als reine Ressourcenverschwendung.
Ein zweistufiges Architekturkonzept zeigt, wie eine deterministische Regelschicht vor dem Modellkern den Weg zu extrem schnellen, sparsamen und stabilen Systemen ebnet.
Das Problem: Der stumme Ressourcenfresser
Typische Implementierungen leiten Anfragen unreflektiert an die Inferenz-Engine weiter:
- Unnötiger Chain-of-Thought (CoT): Das Modell generiert hunderte Tokens internen Monolog, nur um einen JSON-Block oder eine Code-Funktion auszugeben. Jeder dieser Tokens bindet Rechenkapazität und verdoppelt oder verdreifacht die Antwortzeit.
- Statische Kontext-Blockaden: Entweder wird das Kontextfenster standardmäßig zu klein dimensioniert (was bei längeren Code- oder Textausgaben zu abrupten Abbrüchen führt) oder permanent maximal allokiert, was VRAM unnötig bindet und fragmentiert.
- Mangelnde Prompt-Hygiene: Hintergrundprozesse schicken Prompts oft redundant ab, was die Time-to-First-Token (TTFT) künstlich in die Höhe treibt.
Instruct vs. Reasoning: Zwei Modellwelten, zwei Hebel
Um die Wirkung smarter Pipelines empirisch und wissenschaftlich sauber zu bewerten, ist eine grundlegende Unterscheidung der Modellarchitekturen unverzichtbar:
1. Reine Instruct-Modelle (z. B. Gemma, Llama-Instruct, Mistral)
Reine Instruct-Modelle besitzen keine internen <think>-Schleifen. Sie generieren von Natur aus nur die direkte Antwort:
- Token-Reduktion: Hier können keine Denk-Tokens eingespart werden. Bei identischem Prompt liegt die reine Token-Differenz bei exakt 0 Prozent, da das Modell von Haus aus keinen Denk-Ballast mitführt.
- Der reale Hebel: Für solche Modelle wirkt die vorgeschaltete Regelschicht primär als Hardware- und Stabilitäts-Wächter. Sie berechnet den exakten Kontextbedarf (n_{ctx), verhindert Out-of-Memory-Crashes bei langen Generierungen und garantiert unter T = 0.0 absolute bitgenaue Reproduzierbarkeit (100 % Determinismus).
2. Reasoning-Modelle (z. B. DeepSeek-R1, QwQ, Qwythos-Mythos)
Modelle mit inhärentem Chain-of-Thought erzeugen standardmäßig einen massiven Überhang an Vorüberlegungen, selbst wenn nur eine kurze Übersetzung, Formatierung oder Datentransformation gefordert wird:
- Token-Reduktion: Hier entfaltet die Pipeline ihr volles Potenzial: Durch gezielte Direktiveninjektion und Post-Filterung werden 40 bis 60 Prozent der Tokens eliminiert.
- Der reale Hebel: Die Ausführungszeit bricht massiv ein, der Stromverbrauch sinkt proportional und der KV-Cache im Grafikspeicher bleibt frei für parallele Batch-Anfragen.
Die zweistufige Pipeline: Konzept & Architektur
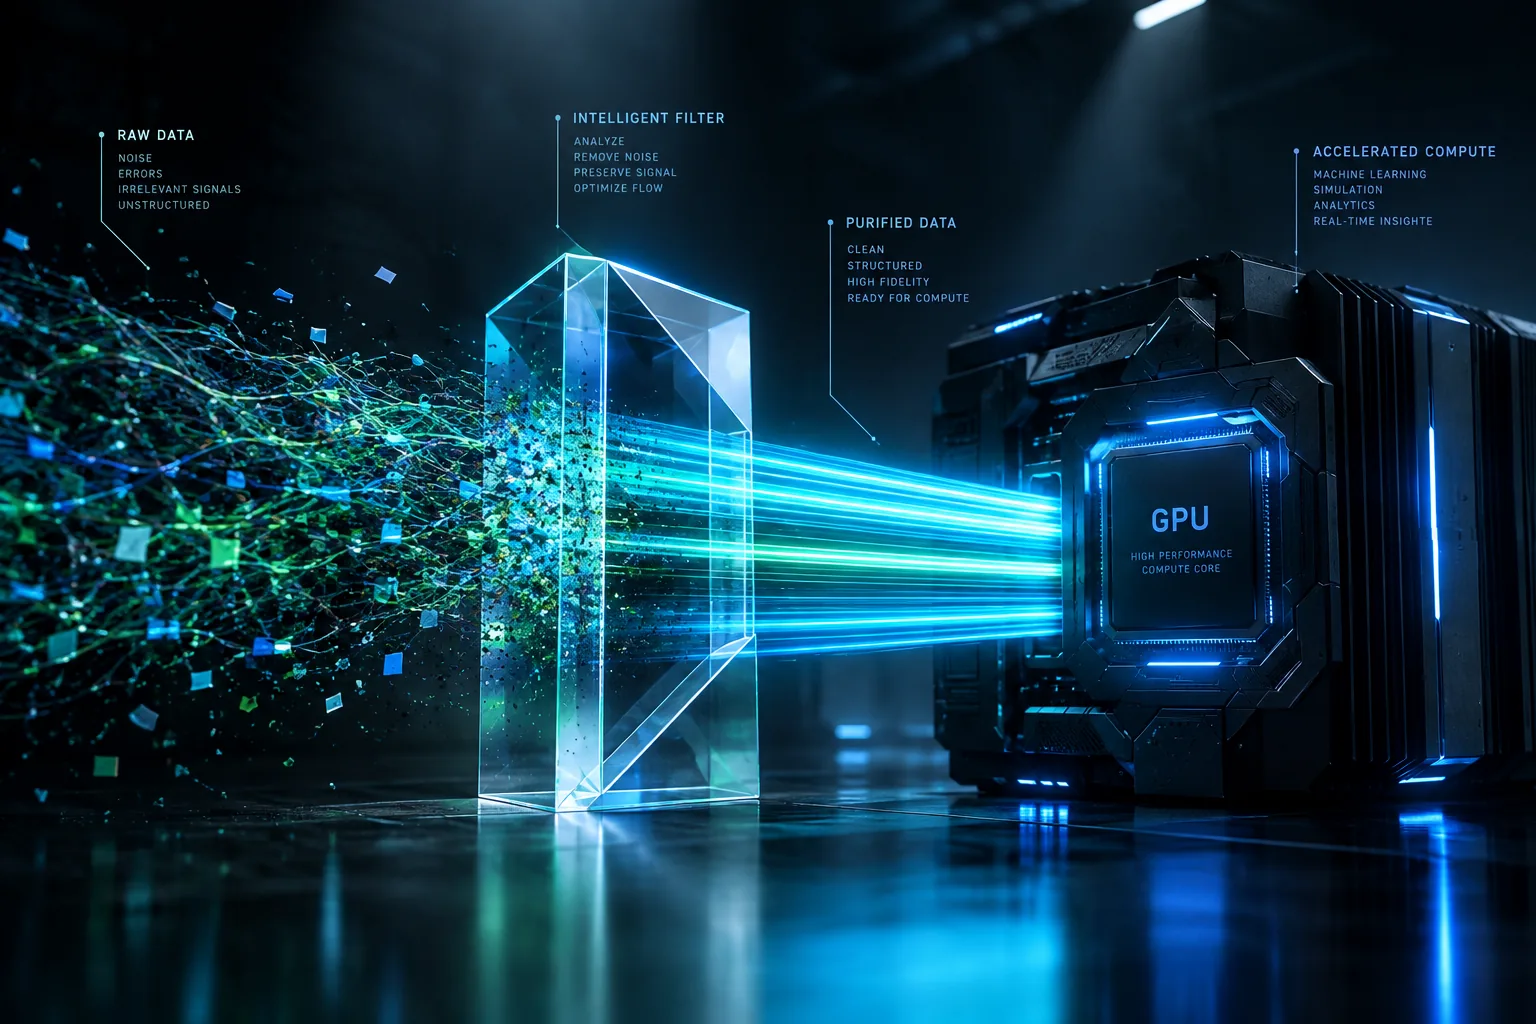
Statt jede Anfrage ungefiltert in die Inferenz-Engine laufen zu lassen, trennt diese Architektur die Aufgaben strikt: Regelbasierte Vorarbeit auf der CPU, reine Nutzlast-Generierung auf der GPU bzw. dem Beschleuniger.
Architektur-Workflow: Zweistufige Inferenz-Pipeline
Die Funktionsweise im Detail
- Direktive Injektion vor Inferenz: Erkennt die Engine ein Reasoning-Modell oder zeitkritische Standardaufgaben, injiziert sie auf System-Ebene strikte Instruktionen, die das Erzeugen von Denk-Tags unterbinden. Das Modell springt direkt zur Nutzlast.
- Dynamische Kontext-Skalierung: Erkennt der Filter Schlüsselbegriffe für umfangreiche Ausgaben (z. B. vollständige Code-Refactorings oder lange Textabschnitte), berechnet er den voraussichtlichen Token-Bedarf im Vorfeld. Das Kontextfenster wird bedarfsgerecht auf die nächste stabile Speicherstufe gehoben, statt blind Speicher zu reservieren oder mitten im Satz abzubrechen.
- Post-Filter-Absicherung: Falls das Sprachmodell dennoch minimale Rest-Tags ausgibt, fängt die Rücklauf-Logik diese ab, bevor die Antwort die anfragende Anwendung erreicht.
Lokale Workstations vs. Globale Cloud: Wo liegt der Hebel?
Das Prinzip entfaltet auf beiden Plattformen enorme Wirkung, adressiert jedoch unterschiedliche Engpässe:
1. Auf der lokalen Workstation (z. B. Entwickler-PC / Studio)
- VRAM-Schutz: Lokale Grafikkarten besitzen feste Speichergrenzen. Ein dynamischer Filter verhindert, dass unnötig große Kontextfenster allokiert werden oder der Speicher durch Fragmentierung blockiert wird.
- Temperatur & Stromverbrauch: Die Hardware taktet sofort nach der eigentlichen Generierung wieder herunter, statt sekundenlang an verworfenen Gedankengängen zu rechnen.
- Zuverlässigkeit: Längere Ausgaben brechen nicht mehr mitten im Satz ab, weil der Filter dem Kontextfenster vorab automatisch die nötige Token-Reserve zuweist.
2. In großen Cloud-Clustern & Rechenzentren
- KV-Cache-Entlastung: In Serverfarmen ist der High-Bandwidth-Memory (HBM) der teuerste Flaschenhals. Wenn Millionen parallele Abfragen hunderte Tokens lang „nachdenken“, verstopft der interne KV-Cache den gesamten Cluster. Das Einsparen dieser Tokens vervielfacht den Gesamtdurchsatz.
- Dramatische Kostensenkung: Sowohl bei API-Abrechnungen pro Token als auch bei reinen Hosting-Kosten senkt das Eliminieren überflüssiger Tokens die Betriebskosten bei Reasoning-Modellen um bis zu 40–60 Prozent.
- Verkürzte Latenz: Systeme reagieren ohne spürbare interne Bedenkzeit unmittelbar.
Chancen und Risiken des Konzepts
| Dimension | Vorteile der Architektur | Mögliche Nachteile & Grenzen |
|---|---|---|
| Geschwindigkeit | Unmittelbare Ausgabe bei Reasoning-Modellen; Wegfall von 40–60 % Wartezeit. | Bei reinen Instruct-Modellen keine Latenzverkürzung durch CoT-Sperre (da kein CoT existiert). |
| Ressourcen | Geringere GPU-Auslastung, weniger VRAM-Bedarf, messbare Stromeinsparung (Joules). | Minimaler CPU-Mehraufwand für die Heuristik (im Mikrosekundenbereich). |
| Stabilität | Dynamische Token-Reserven verhindern Context-Crashes bei langen Antworten. | Falsche Heuristiken könnten Puffer im Einzelfall zu knapp kalkulieren. |
| Inhaltliche Tiefe | Präzise, deterministische Ergebnisse für Standardaufgaben, CMS und Code. | Qualitätsverlust bei echtem Reasoning: Komplexe Logik- und mathematische Beweisaufgaben benötigen Denk-Tokens zur Selbstkorrektur. |
Fazit: Die Zukunft gehört hybriden Systemen
Reine neuronale Netze sind hervorragende Generatoren, aber schlechte Ressourcenverwalter. Ihnen das gesamte Prozess- und Speichermanagement zu überlassen, ist ineffizient.
Indem deterministische, klassisch programmierte Filter vor die stochastische Modell-Engine geschaltet werden, wird dem Gesamtsystem unnötiger Ballast genommen. Klassischer Code übernimmt das, was er am besten kann (Regeln, Speicherberechnung, Strukturierung), während dem Sprachmodell die präzise Formulierung überlassen bleibt.
Diese Symbiose ist der Schlüssel, um lokale wie globale KI-Pipelines wirtschaftlich, reaktionsschnell und stabil zu betreiben.